고른 모델이 프로젝트 요구를 못 따라가면 AI 영상 작업은 금방 지쳐요. 많은 도구가 캐릭터를 흔들고, 짧은 클립만 내거나, 제작 품질이 기대보다 낮아요. 도구를 바꿔 가며 쓰면 시간도 잃고, 완성 전에 편집이 더 늘어요. 이 가이드는 창작자에게 실제로 중요한 기능으로 가장 쓸 만한 텍스트 투 비디오 AI 모델을 비교해요.
1부. 가장 쓸 만한 텍스트 투 비디오 AI 모델을 고르는 법
텍스트 투 비디오 AI 모델을 고를 때는 최종 화질과 작업 흐름을 바꾸는 기능을 봐야 해요. 창작 프로젝트에 맞는 모델을 고르기 전에, 아래 5가지를 먼저 살펴보세요.
- 프롬프트 해석: 해석이 좋으면 영상이 글 지시에 더 가깝고, 반복 생성이 줄어요.
- 최대 출력 길이: 한 번에 나오는 클립이 길수록, 한 프롬프트로 긴 영상을 만들 때 반복 생성이 줄어요.
- 캐릭터와 장면 일관성: 캐릭터가 탄탄하면 사람, 옷, 장면이 영상 내내 같아 보여요.
- 네이티브 오디오: 네이티브 오디오는 대사, 음악, 효과음을 영상과 함께 자동으로 만들어요.
- 해상도와 내보내기 옵션: 더 높은 해상도와 유연한 내보내기는 플랫폼과 기기별로 더 나은 영상을 줘요.
2부. 2026년 가장 쓸 만한 텍스트 투 비디오 AI 모델 6종
모델마다 강점이 달라요. 창작 목표와 제작 요구에 따라 갈려요. 아래에서 가장 쓸 만한 텍스트 투 비디오 AI 모델을 소개하고, 무엇이 다른지 설명해요.
1. MagicLight AI
가장 잘 맞는 경우: 글 이야기, 스크립트, 연재 콘텐츠를 내레이션 있는 롱폼 영상으로 바꾸는 창작자.
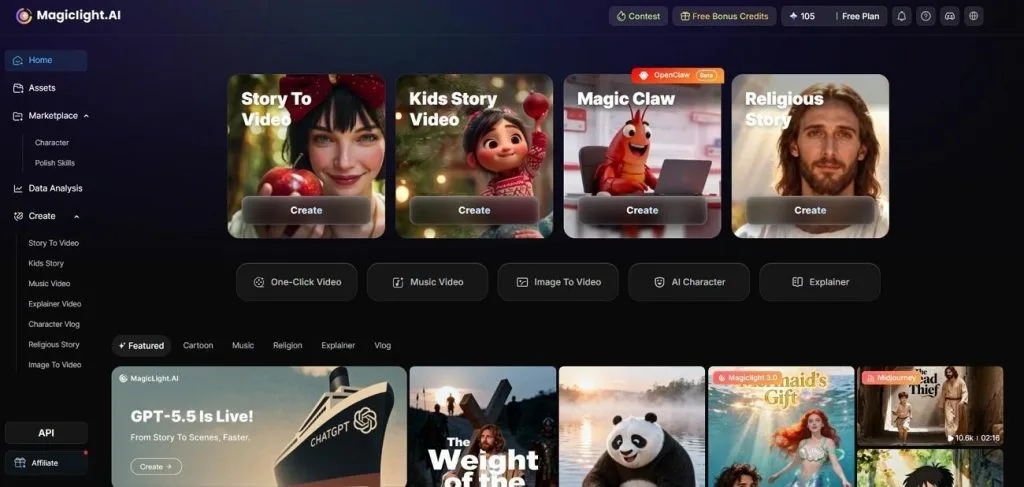
MagicLight AI는 창작자가 프롬프트를 쪼개지 않고, 완성 스크립트에서 영상을 만들어요. 처음부터 한 작업 흐름 안에서 장면, 보이스오버, 영상을 생성해요.
37가지 목소리 중에서 고르거나 내 목소리를 복제해서 개인 내레이션을 넣을 수 있어요.
11개 언어를 지원해서 여러 지역의 시청자에게 영상을 낼 수 있어요. 간단한 텍스트 프롬프트로 캐릭터, 카메라, 감정, 장면 동작을 다루며 기술 경험은 필요 없어요. MagicLight AI는 설명 영상, 교육 영상, 어린이 이야기, 서사 콘텐츠에 특히 잘 맞아요.
주요 기능
- 롱폼 영상 지원: 최대 12,000자 프롬프트로 약 50분까지 영상을 만들어, 클립을 손으로 이어 붙일 필요가 없어요.
- Nano Storyboard 편집: 렌더 전에 장면을 편집 가능한 단계로 나누고, 50개 포즈와 타이밍을 조정해요.
- 캐릭터 일관성: 모든 장면에서 같은 외형과 얼굴을 유지하도록 캐릭터를 만들기.
- 시각 스타일 범위: 스타일 패밀리는 Midjourney V7과 MagicLight 자체 3.0, 2.2, 2.0 모델을 아우르며 사실적, Disney, Pixar, 애니, 일러스트 룩을 커버해요.
- 게시 가능한 내보내기: 완성된 1080p 영상에 자막, 배경 음악, 자동 생성된 커버가 함께 나가요.
장점
- 프롬프트를 쪼개지 않고 한 스크립트에서 완성 스토리 영상을 만들어요.
- 최종 영상을 만들기 전에 장면 순서와 호흡을 검토할 수 있어요.
- 유료 플랜에는 웹, iOS, Android 상업 이용 권한이 포함돼요.
단점
- 최대 해상도는 1080p이고 네이티브 4K는 없어요.
2. Google Veo 3
가장 잘 맞는 경우: 소셜과 마케팅용으로, 동기화된 오디오가 있는 짧고 사실적인 영상을 만드는 사용자.
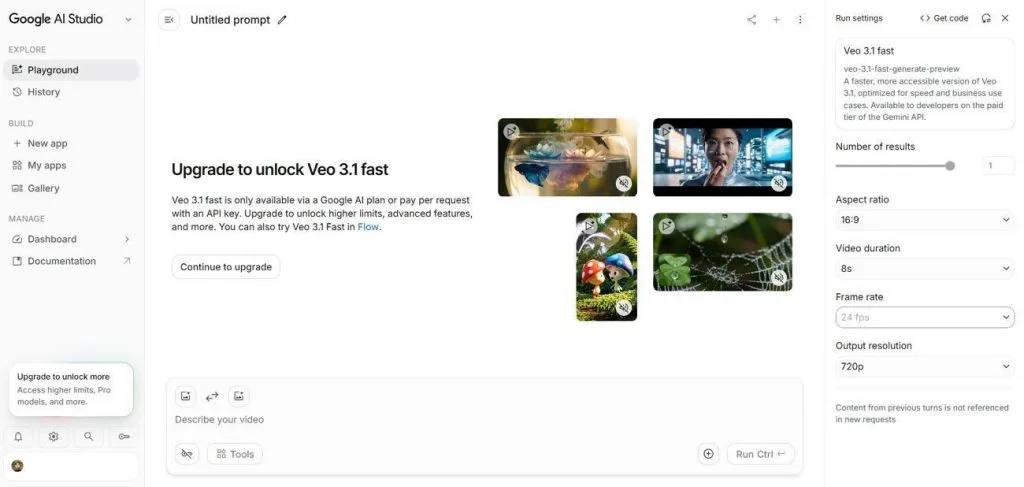
Google Veo 3는 간단한 텍스트 프롬프트로 자연스러운 움직임이 있는 사실적 영상에 집중해요. 세부 지시를 잘 이해해서 장면이 설명에 가깝고 수정이 적어요. 전 세계 창작자는 Gemini, Google Flow, Gemini API로 쓸 수 있어요.
주요 기능
- 대사, 효과음, 배경 분위기를 모든 영상과 함께 자동 생성해요.
- 지원 프로젝트에서 더 선명한 최종 화질을 위해 선택적 4K 업스케일을 내보낼 수 있어요.
- 세부 프롬프트를 정확히 이해해 사실적인 움직임과 자연스러운 사물 상호작용을 꾸준히 만들어요.
장점
- 별도 편집 소프트웨어 없이 동기화된 오디오를 만들어요.
- 정확한 모션과 자연스러운 물리로 사실적 영상을 만들어요.
단점
- 8초 클립만 지원해서 나중에 여러 번 생성해야 해요.
- 유료 Google AI 구독이 필요하고, 월 20달러부터예요.
3. Kling AI 2.0
가장 잘 맞는 경우: 부드러운 시각 스토리와 드라마틱한 장면이 있는 시네마틱 숏폼.
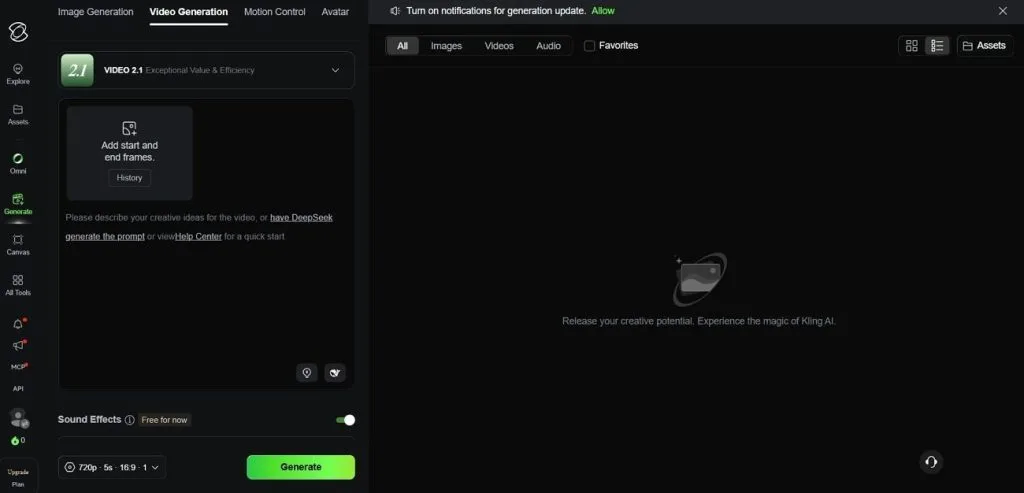
Kling AI는 텍스트 프롬프트로 시네마틱 영상을 만드는 텍스트 투 비디오 모델이에요. 고급 제작 기술 없이도 다듬어진 비주얼을 내는 데 집중해요. Kling AI 2.0을 넘어선 추가 기능이 있는 더 새 버전도 고를 수 있어요.
주요 기능
- 마스터 엔진이 시네마틱 카메라 움직임과 더 부드러운 모션을 만들어요.
- Extend가 10초 클립을 자연스럽게 약 3분까지 늘려 줘요.
- 사실적인 사람 표정과 역동적 액션 장면을 일관된 화질로 만들어요.
장점
- 정확한 전환을 위한 Start and End Frames를 지원해요.
- 유연한 장면 맞춤을 위한 Multi-Elements 편집이 있어요.
단점
- 무료 결과물은 워터마크가 있고 비상업용이에요.
- 2.0에는 네이티브 오디오가 없고, 4K는 Kling 3.0에 있어요.
4. Runway (Gen-4.5)
가장 잘 맞는 경우: 사실적 모션, 부드러운 애니메이션, 세밀한 시각 스토리가 필요한 시네마틱 AI 영상.
간단한 텍스트와 이미지 프롬프트로 시네마틱 영상을 만드는 AI 영상 생성기예요. Runway의 Gen-4.5는 사실적 애니메이션, 부드러운 모션, 세밀한 장면에 집중해 전문적인 결과를 내요. 생성된 영상 전반에서 현실적인 환경, 움직임, 상호작용을 시뮬레이션하는 월드 모델을 키워요.
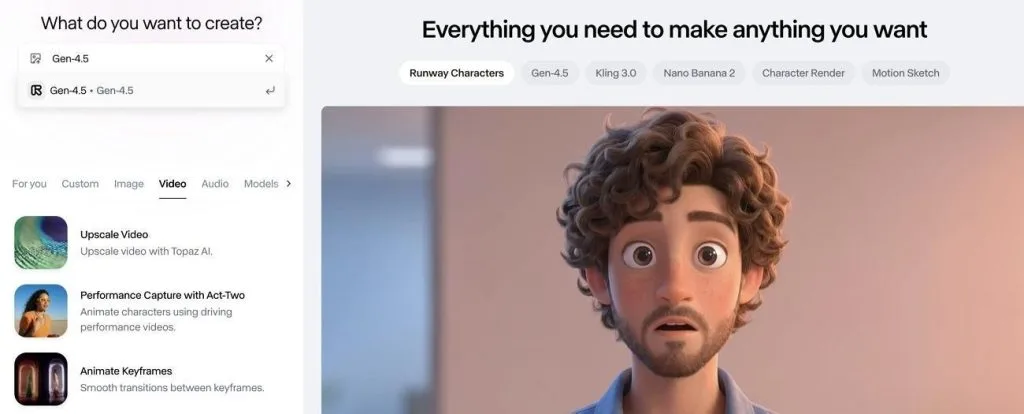
주요 기능
- 16:9와 다른 영상 포맷으로 만들 수 있어요.
- 720p 영상을 만들고, 선택적 4K 업스케일을 지원해요.
- 텍스트 프롬프트와 참조 이미지 모두에서 쉽게 영상을 생성해요.
장점
- 내장 편집기가 여러 생성 클립을 자연스럽게 이어 붙여요.
- 더 긴 프롬프트가 제작 중 반복 장면 조정을 줄여 줘요.
단점
- 여러 번 재생성하면 제작 시간과 비용이 늘어요.
- 높은 가격 때문에 작은 창작자는 자주 테스트하기 어려워요.
5. Pika 2.5
가장 잘 맞는 경우: 스타일라이즈드 애니, 경쾌한 편집, 짧은 소셜 콘텐츠.
널리 쓰이는 텍스트 투 비디오 AI 모델로, 스타일라이즈드 영상을 빠르게 꾸준히 만들어요. Pika 2.5는 생성 사이 대기 없이 여러 아이디어를 빠르게 다듬게 도와요. 짧은 영상 포맷은 자주 올리고 실험해야 하는 소셜 플랫폼에 잘 맞아요.
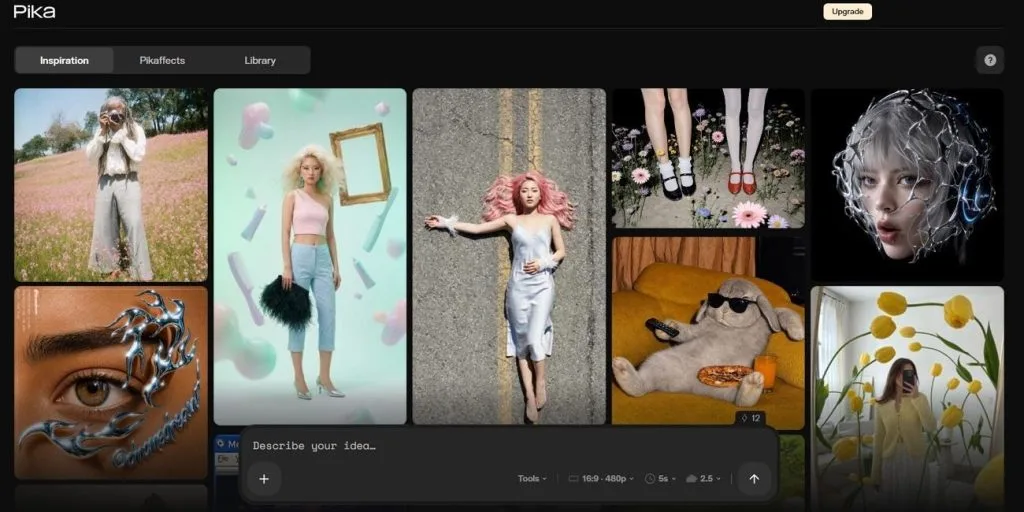
주요 기능
- 유연한 애니메이션 작업을 위해 텍스트 투 비디오와 이미지 투 비디오를 지원해요.
- Shorts와 다른 세로 영상 플랫폼에 최적화되어 있어요.
- 카메라 움직임과 스타일라이즈드 효과로 정지 이미지를 움직이게 해요.
장점
- 키프레임 도구로 더 길고 통제된 시퀀스를 만들어요.
- 편집 도구로 생성된 영상 속 오브젝트를 바꿔요.
단점
- 복잡한 장면은 시네마틱 AI 모델보다 통제력이 약해요.
- 자주 쓰면 고해상도 렌더가 크레딧을 빨리 소모해요.
6. Luma Dream Machine
가장 잘 맞는 경우: 제작 후 고급 색 보정과 정밀한 모션 제어가 필요한 전문 프로젝트.
Luma Dream Machine은 전문 창작을 위한 강한 모션 제어로 사실적 영상을 만들어요. Ray3 모델 패밀리로 화질, 속도, 생성 효율을 꾸준히 올려요. 사실적 영상을 만든 뒤, 렌더가 끝나면 고급 편집을 준비할 수 있어요.
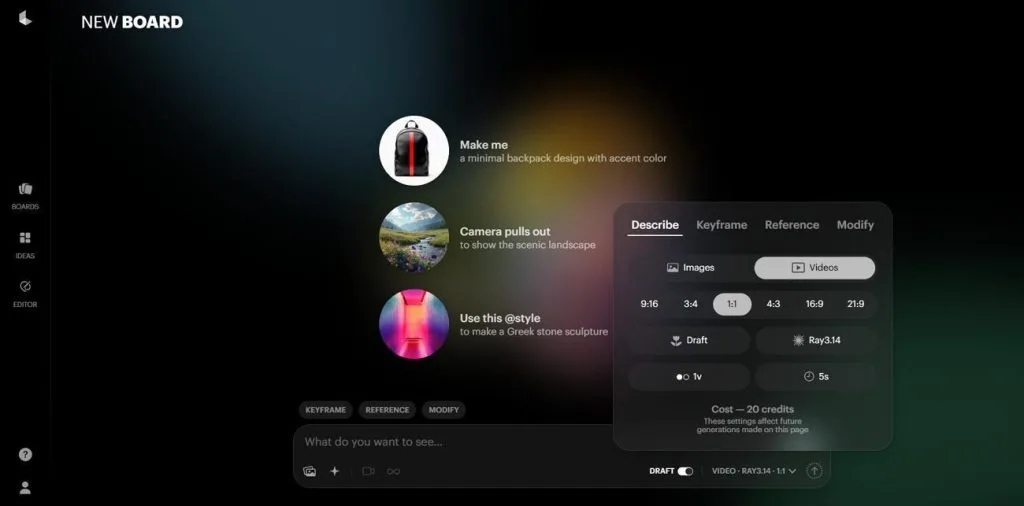
주요 기능
- 전문 편집 워크플로를 위해 네이티브 16-bit HDR 영상과 EXR 내보내기를 만들어요.
- 정밀한 모션 제어를 위해 시작·끝 키프레임과 시각 주석을 지원해요.
- Ray3.14는 더 빠른 1080p 영상을 만들고, 선택적 뉴럴 업스케일로 4K까지 갈 수 있어요.
장점
- 캐릭터 참조가 여러 생성 장면의 일관성을 높여 줘요.
- 더 빠른 Ray3.14 생성이 대기 시간을 줄여 줘요.
단점
- 오디오를 만들지 않아서 사운드는 따로 작업해야 해요.
- 무료 플랜은 품질과 상업 이용을 크게 제한해요.
비교: 텍스트 투 비디오 AI 모델 한눈에 보기
모델마다 영상 목표, 작업 흐름, 프로젝트 요구에 따라 다르게 움직여요. 아래 표는 가장 중요한 기능으로 텍스트 투 비디오 AI 모델을 비교해요:
| 모델 | 최대 출력 길이 | 네이티브 해상도 | 네이티브 오디오 | 캐릭터 일관성 | 가장 잘 맞는 용도 |
| MagicLight AI | 플랜에 따라 최대 50분 | 1080p | 보이스오버와 음악 | 장면 전반에서 우수 | 스크립트 기반 스토리텔링 |
| Google Veo 3 | 약 8초 | 4K | 대사, 효과, 앰비언스 | 클립 안 | 싱크 오디오가 있는 사실적 영상 |
| Kling AI 2.0 | 10초(Extend로 최대 약 3분) | 무료 720p, 유료 1080p와 4K | 2.0에는 없음 | 클립 안 | 시네마틱 카메라 움직임 |
| Runway (Gen-4.5) | 2–10초 | 720p, 4K로 업스케일 | 없음 | 클립 안 | 사실적인 시네마틱 샷 |
| Pika 2.5 | 3–5초(Pikaframes로 최대 25초) | 무료 480p, 유료 1080p | 효과음만 | 클립 간 제한적 | 스타일라이즈드 소셜 영상 |
| Luma Dream Machine | 5초 또는 10초 | 4K(업스케일) | 없음 | 클립 안, Ray3에서 참조 | 전문 후반 작업 |
3부. 스토리텔링에 MagicLight AI가 가장 잘 맞는 이유
대부분의 텍스트 투 비디오 모델은 따로 떨어진 클립을 만들고, 완성 이야기는 나중에 편집해야 해요. MagicLight AI는 렌더 전에 전체 이야기를 계획해서 호흡과 장면 연속성이 자연스러워요. 한 스크립트에서 최대 50분까지 만들 수 있어 반복 생성과 이어 붙이기가 필요 없어요. 캐릭터는 장면 전반에서 일관되어, 끊긴 클립이 아니라 완성 이야기가 나와요.
MagicLight AI에서 텍스트로 영상을 만들려면?
이제 스토리텔링에 가장 잘 맞는 텍스트 투 비디오 AI 모델로 영상을 만드는 단계를 따라가세요:
1단계. 스토리 아이디어를 쓰세요
Story to Video를 열고 Text Box에 프롬프트를 붙여 넣거나 입력해요. 이어서 Visual Style Model을 고르고 AI Story Model을 선택한 뒤, Video Language와 Aspect Ratio를 고르세요. Video Duration을 맞춘 다음 Next를 눌러 계속해요.
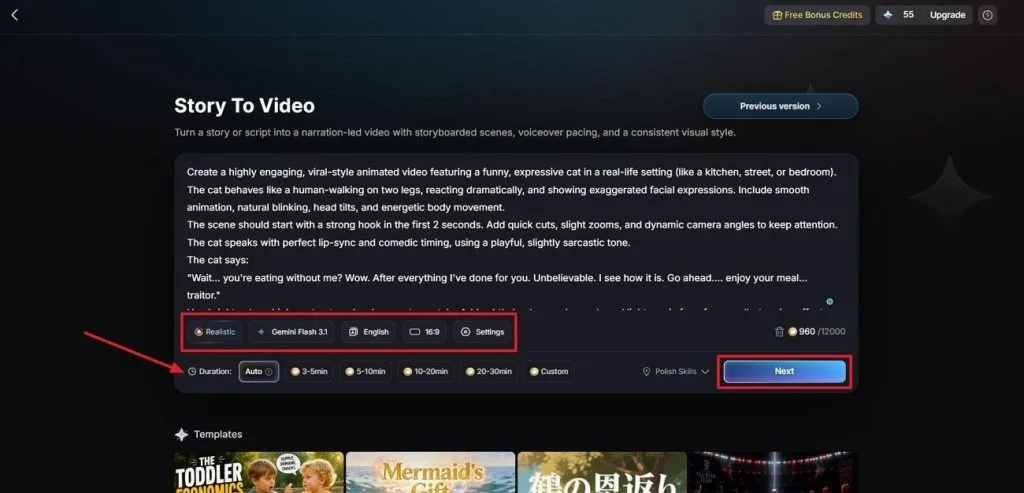
2단계. 장면 분해를 검토하세요
그다음 모든 장면과 Synopsis 분해를 확인해요. 조정이 필요하면 상단 Controls를 쓰세요. 장면 구성이 확정되면 Next를 눌러 진행해요.
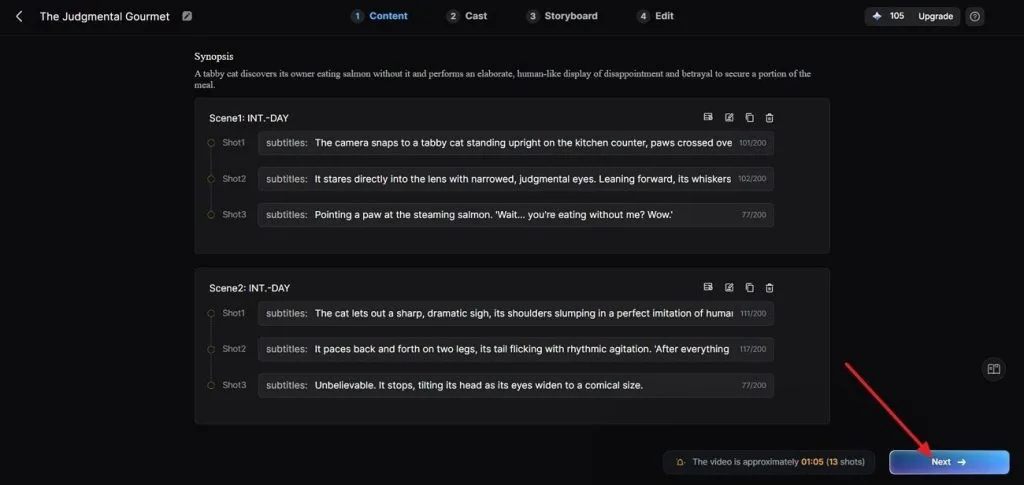
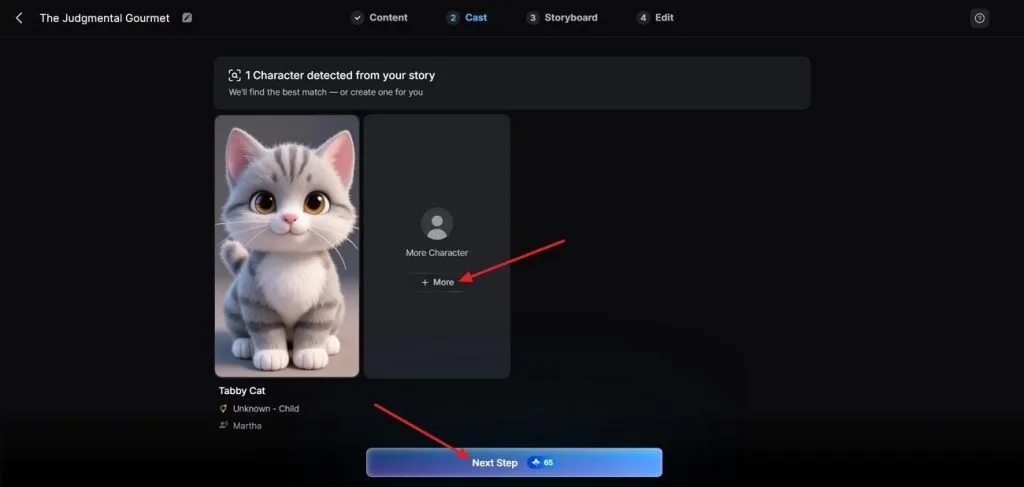
3단계. 영상용 캐릭터를 고르세요
이어서 MagicLight AI가 스크립트를 분석하고 그에 맞는 캐릭터를 제안해요. 더 많은 옵션을 보려면 More를 클릭하세요. 캐릭터가 확정되면 Next Step을 누르세요.
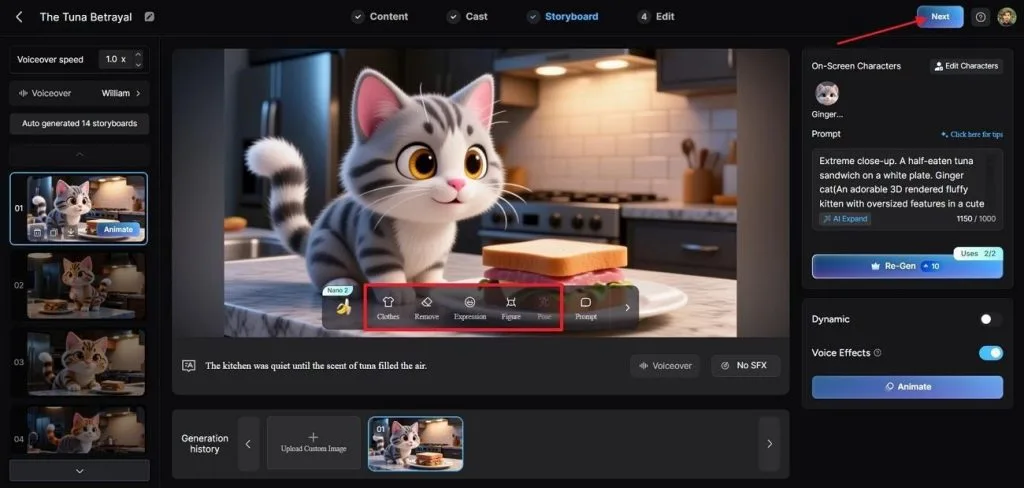
4단계. 스토리보드에서 장면을 검토하세요
그다음 모든 장면을 보고 필요하면 Clothes, Poses, Expressions를 수정해요. 스토리보드가 확정되면 Next를 누르세요.
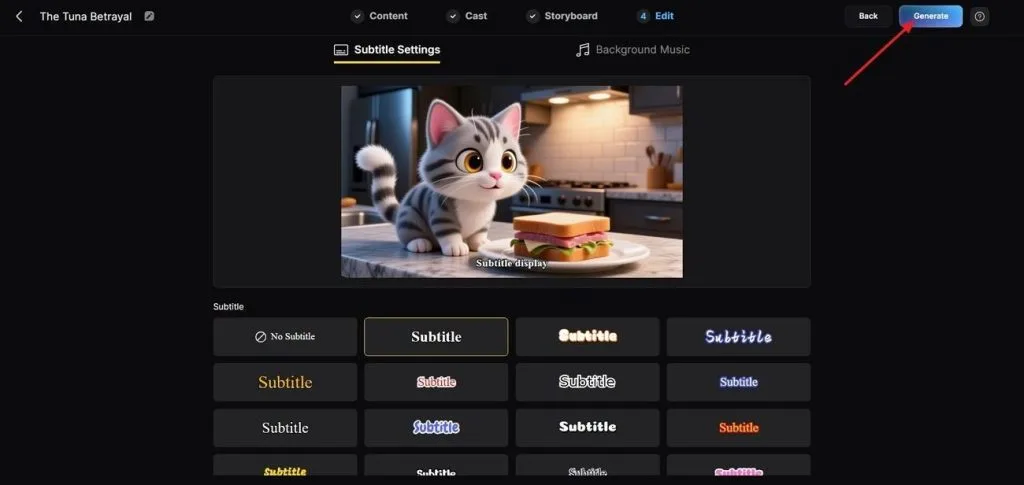
5단계. 자막 스타일을 고르세요
여러 자막 스타일 중 하나를 고르고 오른쪽 위 Generate를 클릭하세요.
6단계. 최종 생성 영상을 저장하세요
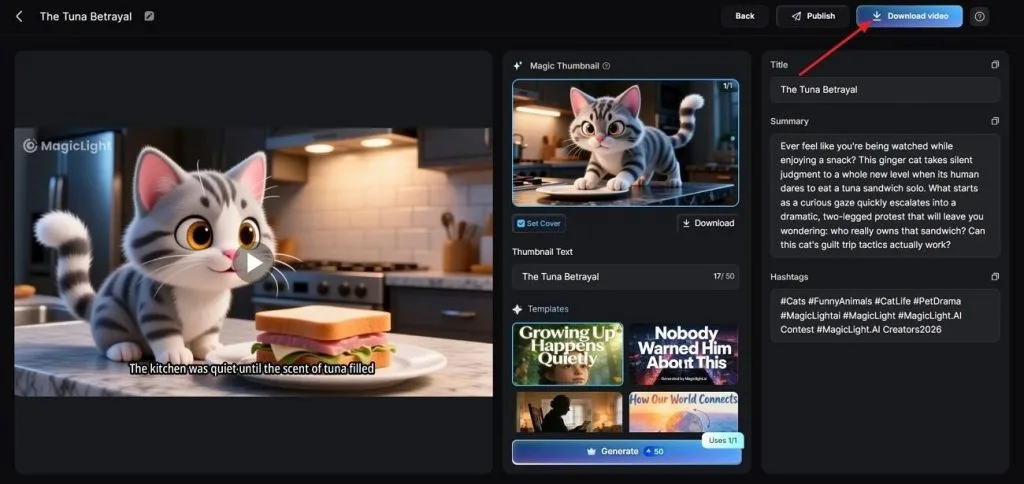
영상이 생성되면 미리 보고 Cover, Thumbnail, Hashtags를 확인하세요. 그다음 Download Video를 눌러 다운로드하세요.
마무리
정리하면, 텍스트 투 비디오 AI 모델은 영상 제작 필요에 따라 강점이 달라요. 콘텐츠 스타일, 작업 흐름, 제작 요구에 맞는 모델을 고르면 결과가 더 일정해요. 스크립트에서 일관된 캐릭터로 완성 이야기를 만들려면 MagicLight AI가 여전히 가장 좋은 선택이에요.
가장 쓸 만한 텍스트 투 비디오 AI 모델 FAQ
1. 2026년 가장 쓸 만한 텍스트 투 비디오 AI 모델은?
처음부터 끝까지 일관된 캐릭터로 완성 이야기를 만들려면 MagicLight AI가 가장 좋아요. 짧고 사실적인 영상, 동기화된 오디오와 자연스러운 모션에는 Veo 3가 더 잘 맞아요.
2. 텍스트 투 비디오 AI 모델은 무료인가요?
대부분 완전 무료 생성 대신 제한된 무료 플랜을 줘요. MagicLight AI는 무료 크레딧을 주고, 다른 도구는 품질, 기능, 상업 이용을 제한해요.
3. 가장 사실적인 영상을 만드는 텍스트 투 비디오 AI 모델은?
Google Veo 3와 Runway Gen-4.5가 자연스러운 모션의 사실적 AI 영상을 가장 잘 만들어요. 둘 다 완성 롱폼 스토리보다 짧은 클립에 집중해요.
4. 텍스트 투 비디오 AI 모델의 차이는?
영상 길이, 오디오 지원, 품질, 장면 간 캐릭터 일관성에서 갈려요. 어떤 모델은 짧은 클립만 만들고, 어떤 모델은 작성된 스크립트에서 완성 영상을 자동으로 만들어요.
5. YouTube 창작자에게 가장 잘 맞는 텍스트 투 비디오 AI 모델은?
MagicLight AI는 완성 스크립트로 더 긴 영상을 만드는 YouTube 창작자에게 맞아요. 다국어 내레이션과 모든 생성 장면에서 일관된 캐릭터를 지원해요.